Los gigantes de la inteligencia artificial (IA) se comprometieron el viernes a ofrecer a los medios de comunicación y otros sitios web una solución para impedir que sus contenidos sean extraídos para entrenar a sus modelos, en un contexto de pulso judicial con parte de la prensa.
Actualmente, los editores tienen que implementar múltiples comandos de bloqueo para cada bot que rastrea la web para recopilar datos.
La nueva solución propuesta les permitirá introducir una sola instrucción estandarizada que será reconocida y respetada por las empresas de IA que adopten el protocolo.
OpenAI, Google, Microsoft y Anthropic se han sumado a la iniciativa.
Sin embargo, la solución no entrará en vigor hasta dentro de varios meses.
Microsoft la implementará a partir del 1 de febrero de 2027, y Google en algún momento de 2027. OpenAI, creadora de ChatGPT, dijo que la adoptará "en los próximos meses". Anthropic, creadora de Claude, afirmó que "ya ha empezado" a hacerlo.
El anuncio llega en un momento en que los editores se enfrentan a un aumento de bots que extraen sus artículos para alimentar modelos de IA. Algunos, como The New York Times, han llevado el asunto a la justicia.
En diciembre de 2023, el Times demandó a OpenAI y Microsoft por supuestamente utilizar millones de sus artículos sin autorización ni pago para entrenar ChatGPT. Las dos empresas invocan una excepción a la ley de derecho de autor.
Te puede interesar

Tecnópolis
NYT afirma que Microsoft y OpenAI sabían que usar artículos periodísticos para entrenar IA era robo
Tecnópolis
Periódicos de Estados Unidos demandan a OpenAI por infracción de derechos de autor
La nueva configuración solo se aplicará al entrenamiento futuro de modelos, pero no impedirá que los bots rastreen de otro modo. Según Microsoft, la extracción de contenido estará permitida por defecto hasta que un editor cambie la preferencia.
Microsoft y Google aseguran que esta elección no afectará la presencia de los sitios en sus motores de búsqueda.
Mas noticias en Tecnologia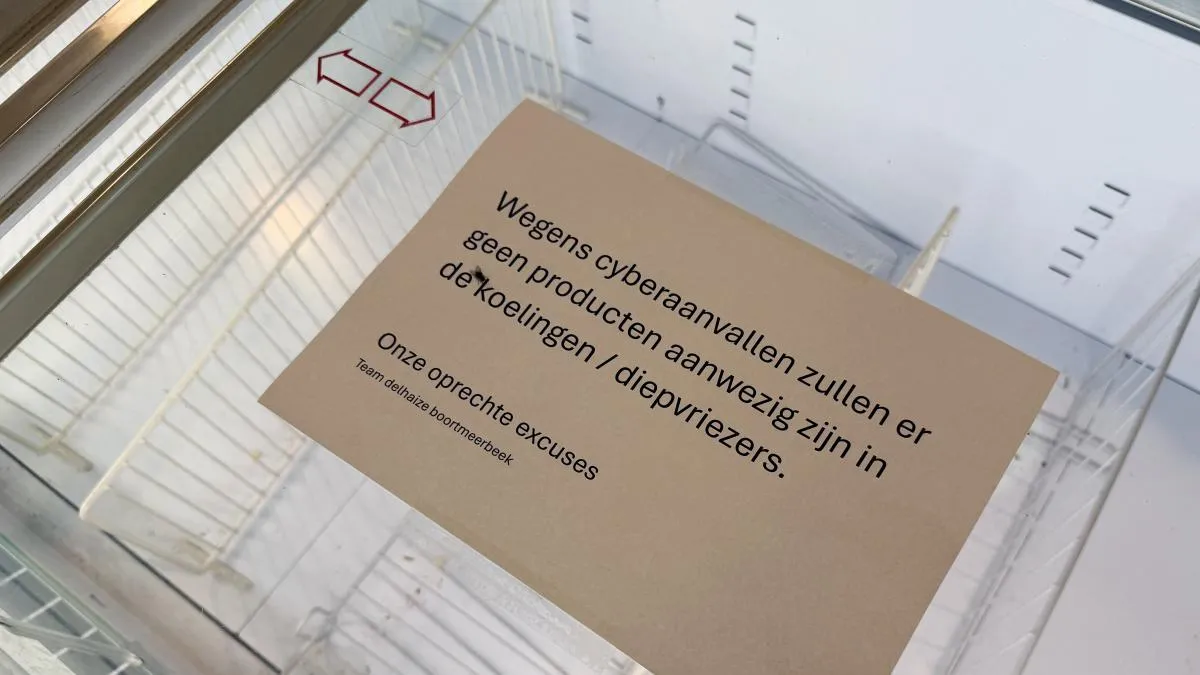
¿Que se sabe del nuevo ciberataque contra los supermercados de varios países europeos?
Un ciberataque disparó las temperaturas de los supermercados europeos este lunes. Afecta a Suecia, Bélgica, Estonia, Finlandia y Luxemburgo, replicando el incidente francés del 12 de octubre con daños significativos para cadenas como Carrefour e Ikea.
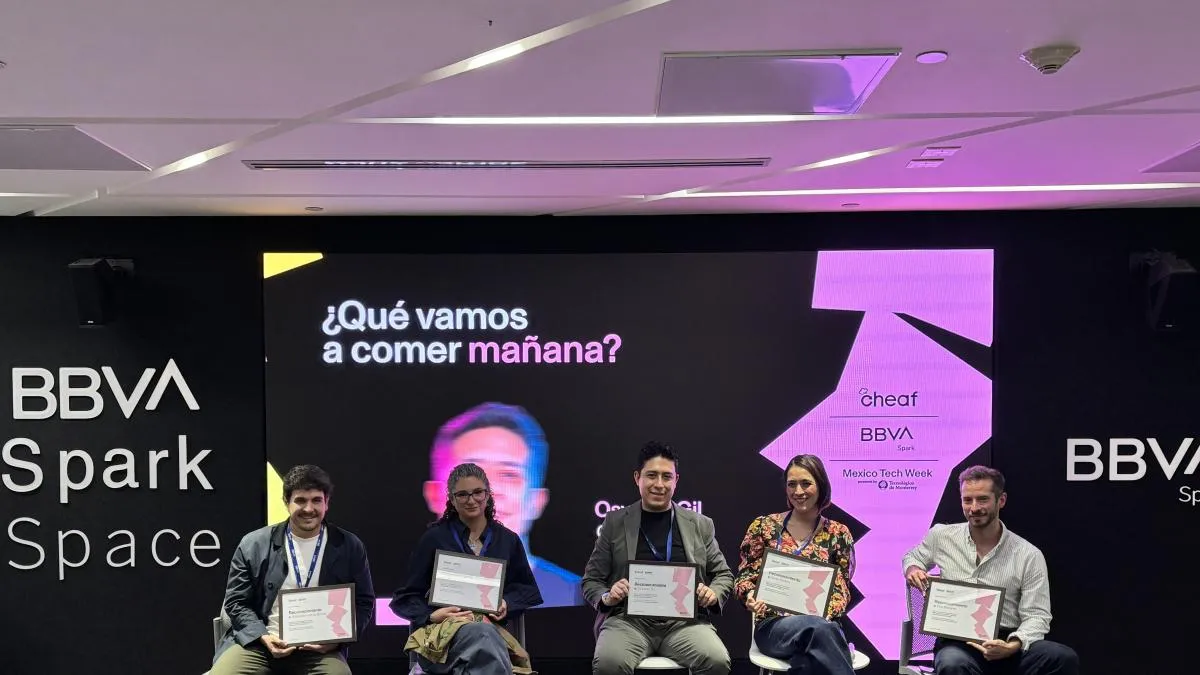
¿Qué vamos a comer mañana? De tortillas con grillos a alimentos hechos con inteligencia artificial
En México Tech Week se presentó cómo la inteligencia artificial, las nuevas proteínas (grillo) y el rastreo alimentario están revolucionando la producción de alimentos. Aunque prometen reducir desperdicios y personalizar dietas, los costos y distribución si...